数据库系统上机实验报告
班级:计算机2305
姓名:徐国超
学号:
实验目的
- 掌握 openGauss 数据库中基本表的创建与管理,能够合理设计数据类型及主键、外键等完整性约束,并熟练进行数据的插入、修改和删除操作。
- 深入掌握 SQL 查询语句的综合运用,包括连接查询、嵌套查询、聚合函数、分组筛选等,能够针对实际需求编写高效的查询语句。
- 掌握视图的创建与应用,理解通过视图简化复杂查询及实现数据访问控制的方法。
- 掌握大规模数据的生成与批量导入技术,通过 Python 结合 JDBC 及多线程方式高效写入数据,并能够对查询性能进行分析与优化(如使用索引、Hint 指令等)。
- 掌握数据库备份与恢复技术,理解触发器的机制与应用,能够通过触发器实现数据变更的自动审计追踪。
实验环境
本实验使用华为云ECS服务器,配置如下
- 操作系统:Huawei Cloud EulerOS
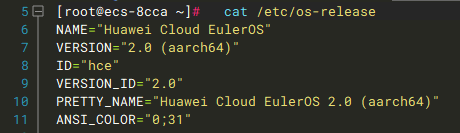
- 规格:鲲鹏通用计算增强型 | 2vCPUs | 4GiB | kc1.large.2
- 数据库版本:OpenGauss-7.0.0-RC1
实验步骤
首先通过Windterm连接至服务器
1 创建数据库和表
首先创建mydb数据库
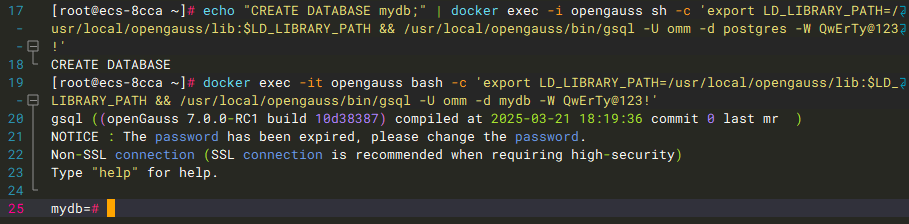
本人学号为2233712046,后三位为046
分别执行命令
CREATE TABLE S046 (
    "S#" VARCHAR(8) PRIMARY KEY,
    SNAME VARCHAR(20) NOT NULL,
    SEX CHAR(3) NOT NULL,
    BDATE DATE,
    HEIGHT NUMERIC(3,2),
    DORM VARCHAR(20)
);
CREATE TABLE C046 (
    "C#" VARCHAR(5) PRIMARY KEY,
    CNAME VARCHAR(30) NOT NULL,
    PERIOD INTEGER,
    CREDIT INTEGER,
    TEACHER VARCHAR(20)
);
CREATE TABLE SC046 (
    "S#" VARCHAR(8) NOT NULL,
    "C#" VARCHAR(5) NOT NULL,
    GRADE NUMERIC(4,1),
    PRIMARY KEY ("S#", "C#"),
    FOREIGN KEY ("S#") REFERENCES S046("S#"),
    FOREIGN KEY ("C#") REFERENCES C046("C#")
);
分别创建表S046、C046和SC046
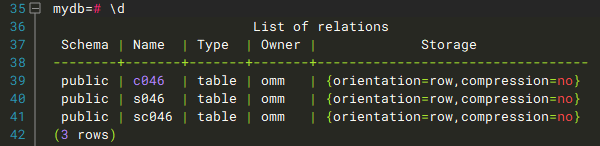
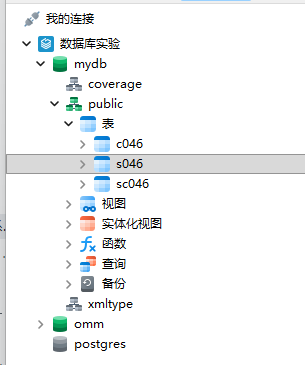
同时可在Navicat中查看
2 插入数据
分别执行命令
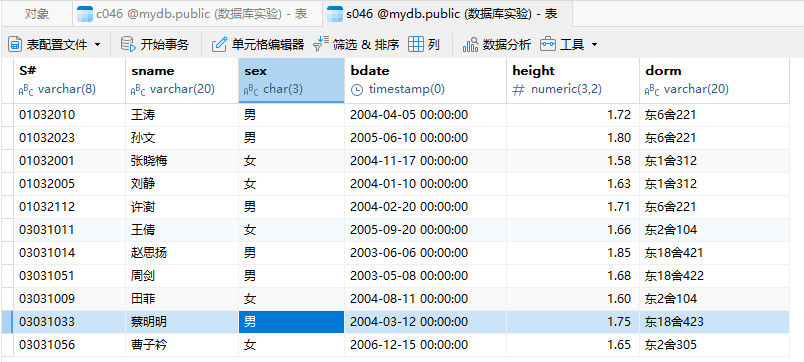
INSERT INTO S046 VALUES
('01032010', '王涛', '男', '2004-04-05', 1.72, '东6舍221'),
('01032023', '孙文', '男', '2005-06-10', 1.80, '东6舍221'),
('01032001', '张晓梅', '女', '2004-11-17', 1.58, '东1舍312'),
('01032005', '刘静', '女', '2004-01-10', 1.63, '东1舍312'),
('01032112', '许澍', '男', '2004-02-20', 1.71, '东6舍221'),
('03031011', '王倩', '女', '2005-09-20', 1.66, '东2舍104'),
('03031014', '赵思扬', '男', '2003-06-06', 1.85, '东18舍421'),
('03031051', '周剑', '男', '2003-05-08', 1.68, '东18舍422'),
('03031009', '田菲', '女', '2004-08-11', 1.60, '东2舍104'),
('03031033', '蔡明明', '男', '2004-03-12', 1.75, '东18舍423'),
('03031056', '曹子衿', '女', '2006-12-15', 1.65, '东2舍305');
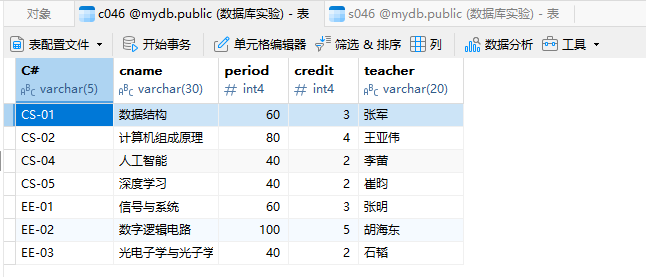
INSERT INTO C046 VALUES
('CS-01', '数据结构', 60, 3, '张军'),
('CS-02', '计算机组成原理', 80, 4, '王亚伟'),
('CS-04', '人工智能', 40, 2, '李蕾'),
('CS-05', '深度学习', 40, 2, '崔昀'),
('EE-01', '信号与系统', 60, 3, '张明'),
('EE-02', '数字逻辑电路', 100, 5, '胡海东'),
('EE-03', '光电子学与光子学', 40, 2, '石韬');
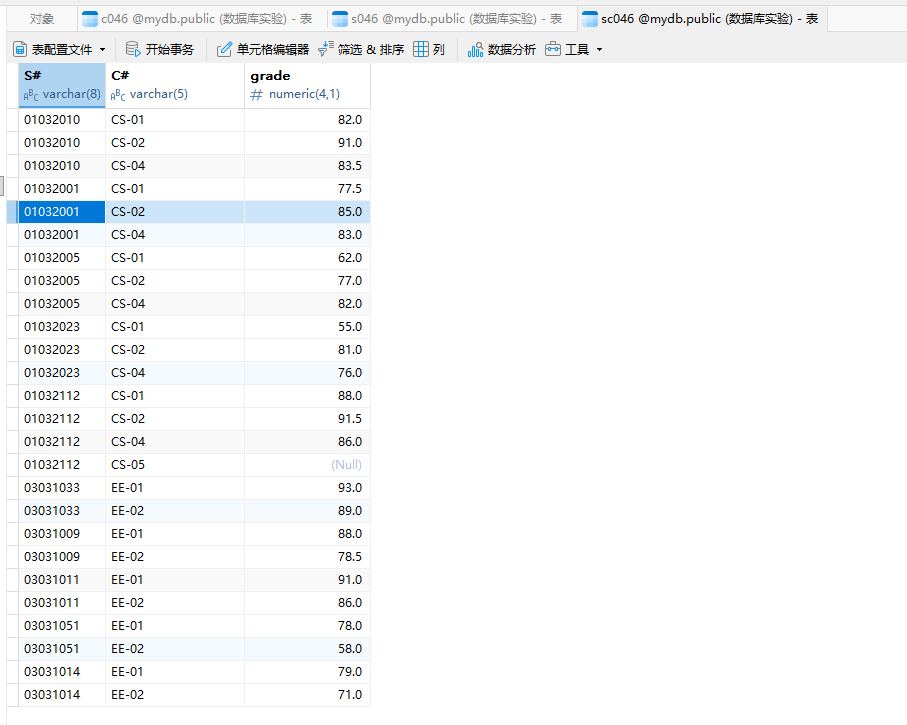
INSERT INTO SC046 VALUES
('01032010', 'CS-01', 82.0),
('01032010', 'CS-02', 91.0),
('01032010', 'CS-04', 83.5),
('01032001', 'CS-01', 77.5),
('01032001', 'CS-02', 85.0),
('01032001', 'CS-04', 83.0),
('01032005', 'CS-01', 62.0),
('01032005', 'CS-02', 77.0),
('01032005', 'CS-04', 82.0),
('01032023', 'CS-01', 55.0),
('01032023', 'CS-02', 81.0),
('01032023', 'CS-04', 76.0),
('01032112', 'CS-01', 88.0),
('01032112', 'CS-02', 91.5),
('01032112', 'CS-04', 86.0),
('01032112', 'CS-05', NULL),
('03031033', 'EE-01', 93.0),
('03031033', 'EE-02', 89.0),
('03031009', 'EE-01', 88.0),
('03031009', 'EE-02', 78.5),
('03031011', 'EE-01', 91.0),
('03031011', 'EE-02', 86.0),
('03031051', 'EE-01', 78.0),
('03031051', 'EE-02', 58.0),
('03031014', 'EE-01', 79.0),
('03031014', 'EE-02', 71.0);
插入成功后在Navicat中查看结果
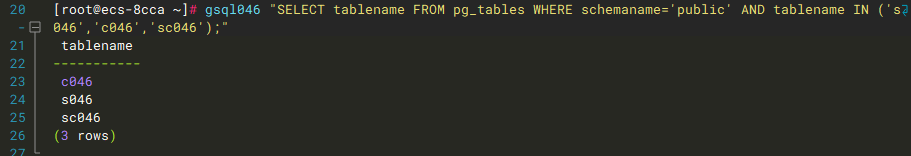
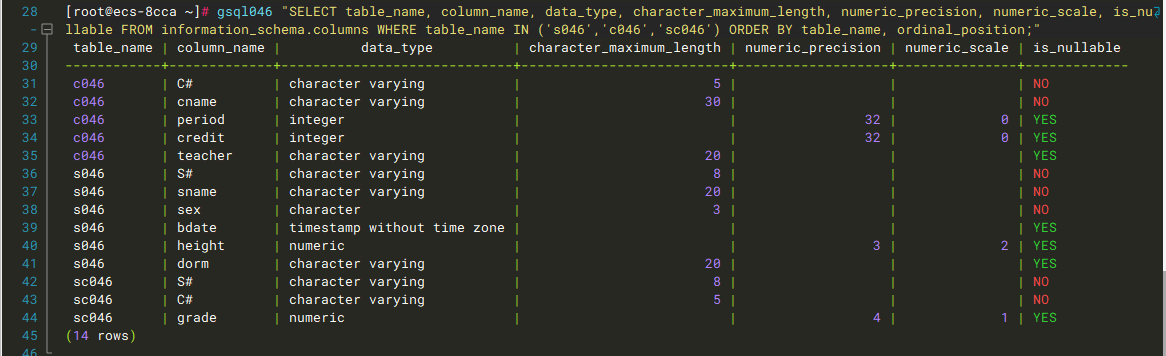
然后根据实验要求通过SQL语句在数据目录系统表中查询出S046、C046、SC046各表及属性信息
使用以下命令
SELECT tablename FROM pg_tables WHERE schemaname='public' AND tablename IN ('s046','c046','sc046');
SELECT table_name, column_name, data_type, character_maximum_length, numeric_precision, numeric_scale, is_nullable FROM information_schema.columns WHERE table_name IN ('s046','c046','sc046') ORDER BY table_name, ordinal_position;
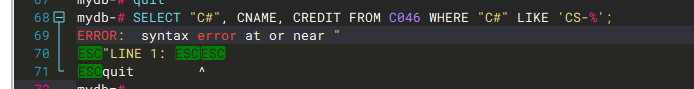
由于openGauss命令行客户端gsql在原生交互模式下,通过WindTerm粘贴多行时,会显示控制字符干扰显示,例如
为保证可读性,这里及后续采用管道方式执行SQL语句,避免终端字符干扰,确保结果准确可靠,执行结果与直接在数据库cli中执行结果一致。
3 基本SQL操作
3.1 在表上完成以下查询
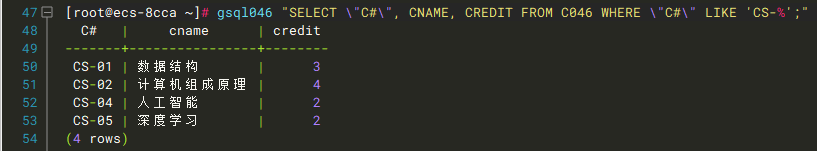
3.1.1 查询计算机系(CS)所开课程的课程编号、课程名称及学分数。
执行命令
SELECT "C#", CNAME, CREDIT FROM C046 WHERE "C#" LIKE 'CS-%';
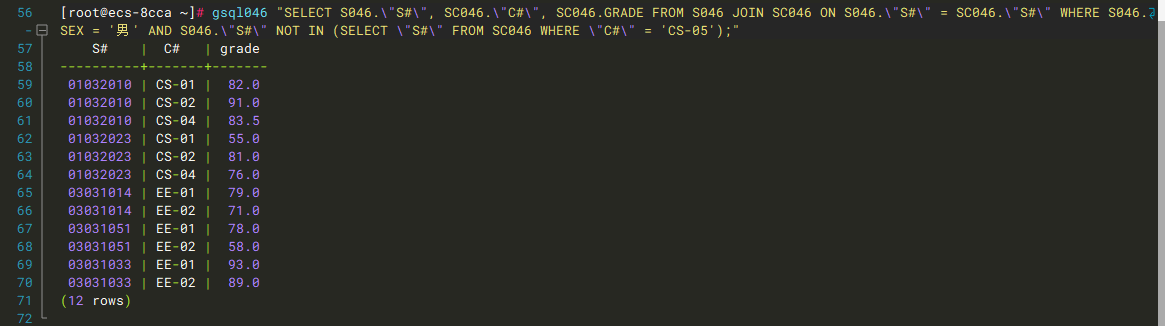
3.1.2 查询未选修课程“CS-05”的男生学号及其已选各课程编号、成绩。
执行命令
SELECT S046."S#", SC046."C#", SC046.GRADE
FROM S046 JOIN SC046 ON S046."S#" = SC046."S#"
WHERE S046.SEX = '男'
  AND S046."S#" NOT IN (SELECT "S#" FROM SC046 WHERE "C#" = 'CS-05');
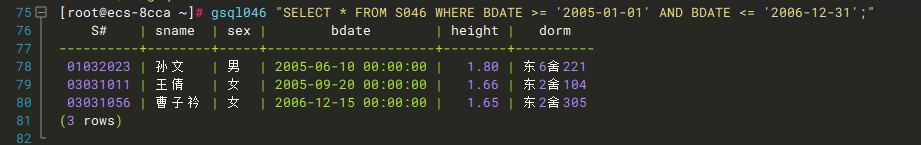
3.1.3 查询2005年~2006年出生学生的基本信息。
执行命令
SELECT * FROM S046 WHERE BDATE >= '2005-01-01' AND BDATE <= '2006-12-31';
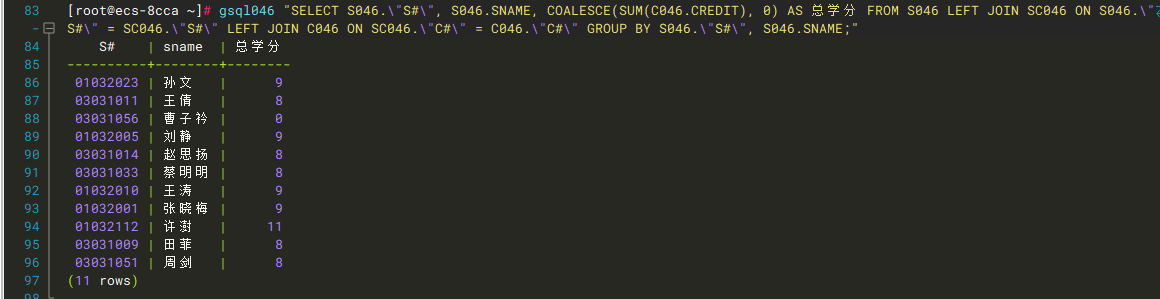
3.1.4 查询每位学生的学号、学生姓名及其已选修课程的学分总数。
执行命令
SELECT S046."S#", S046.SNAME, COALESCE(SUM(C046.CREDIT), 0) AS 总学分
FROM S046
LEFT JOIN SC046 ON S046."S#" = SC046."S#"
LEFT JOIN C046 ON SC046."C#" = C046."C#"
GROUP BY S046."S#", S046.SNAME;
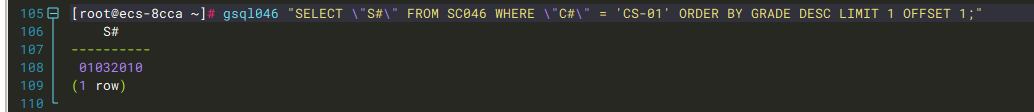
3.1.5 查询选修课程“CS-01”的学生中成绩第二高的学生学号。
执行命令
SELECT "S#" FROM SC046
WHERE "C#" = 'CS-01'
ORDER BY GRADE DESC
LIMIT 1 OFFSET 1;
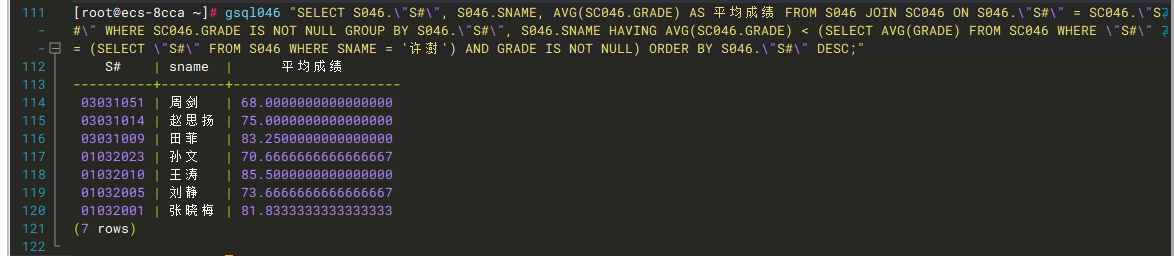
3.1.6 查询平均成绩低于“许澍”同学的学生学号、姓名和平均成绩,并按学号进行降序排列。
执行命令
SELECT S046."S#", S046.SNAME, AVG(SC046.GRADE) AS 平均成绩
FROM S046 JOIN SC046 ON S046."S#" = SC046."S#"
WHERE SC046.GRADE IS NOT NULL
GROUP BY S046."S#", S046.SNAME
HAVING AVG(SC046.GRADE) < (
    SELECT AVG(GRADE) FROM SC046 WHERE "S#" = (
        SELECT "S#" FROM S046 WHERE SNAME = '许澍'
    ) AND GRADE IS NOT NULL
)
ORDER BY S046."S#" DESC;
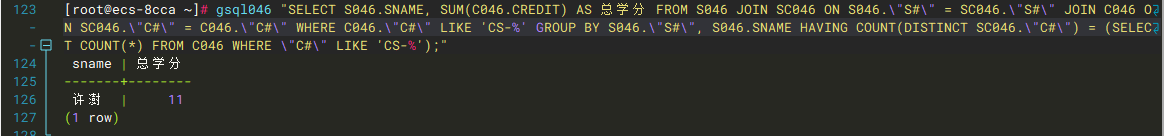
3.1.7 查询选修了计算机专业全部课程(课程编号为“CS-××”) 的学生姓名及已获得的学分总数。
执行命令
SELECT S046.SNAME, SUM(C046.CREDIT) AS 总学分
FROM S046
JOIN SC046 ON S046."S#" = SC046."S#"
JOIN C046 ON SC046."C#" = C046."C#"
WHERE C046."C#" LIKE 'CS-%'
GROUP BY S046."S#", S046.SNAME
HAVING COUNT(DISTINCT SC046."C#") = (SELECT COUNT(*) FROM C046 WHERE "C#" LIKE 'CS-%');
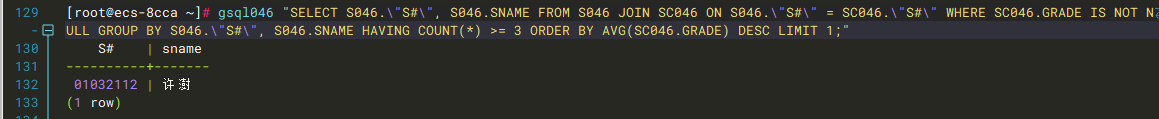
3.1.8 查询选修了3门以上课程(包括3门)的学生中平均成绩最高的同学学号及姓名。
执行命令
SELECT S046."S#", S046.SNAME
FROM S046 JOIN SC046 ON S046."S#" = SC046."S#"
WHERE SC046.GRADE IS NOT NULL
GROUP BY S046."S#", S046.SNAME
HAVING COUNT(*) >= 3
ORDER BY AVG(SC046.GRADE) DESC
LIMIT 1;
3.2 加入记录
分别在S046和C046表中加入记录
(‘01032005’,‘刘竞’,‘男’, ‘2003-12-10’, 1.75,‘ 东 14 舍 312’)以及
(‘CS-03’,“离散数学”,64,4,‘陈建明’)。、
执行以下指令
INSERT INTO S046 VALUES ('01032005', '刘竞', '男', '2003-12-10', 1.75, '东14舍312');
INSERT INTO C046 VALUES ('CS-03', '离散数学', 64, 4, '陈建明');
插入第一条时报错

如果要替换的话可以先删除原有记录再插入,这里由于外键约束先删除了选课记录

插入后结果如下



3.3 删除S046中已修学分数大于20的学生记录
存在外键约束,所以如果要删除的话应该先删除SC046中的记录,再删除S046中的
分别执行以下命令
DELETE FROM SC046 WHERE "S#" IN (
    SELECT S046."S#" FROM S046
    LEFT JOIN SC046 ON S046."S#" = SC046."S#"
    LEFT JOIN C046 ON SC046."C#" = C046."C#"
    GROUP BY S046."S#"
    HAVING COALESCE(SUM(C046.CREDIT), 0) > 20
);
DELETE FROM S046 WHERE "S#" IN (
    SELECT S046."S#" FROM S046
    LEFT JOIN SC046 ON S046."S#" = SC046."S#"
    LEFT JOIN C046 ON SC046."C#" = C046."C#"
    GROUP BY S046."S#"
    HAVING COALESCE(SUM(C046.CREDIT), 0) > 20
);

并没有数据被删除,没有学生已修分数大于20
3.4 调整学时和学分
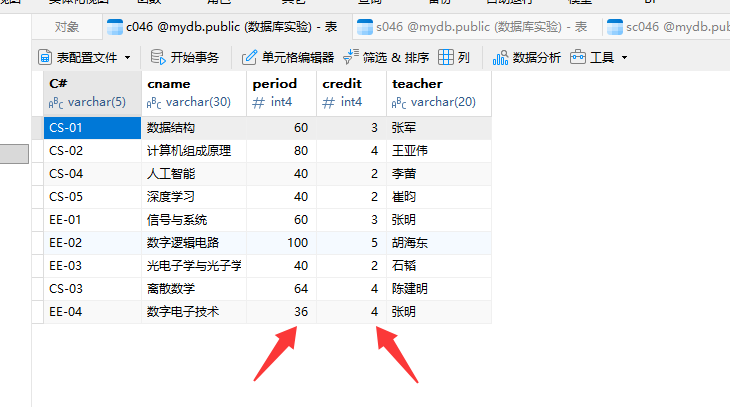
将“张明”老师负责的“数字电子技术”课程的学时数调整为36,同时增加一个学分。
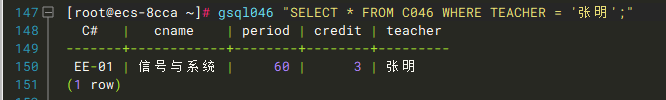
查询C046表发现并没有“张明”老师负责的“数字电子技术”课程
如果要进行修改的话可以先新增一个再修改
执行以下命令
INSERT INTO C046 VALUES ('EE-04', '数字电子技术', 60, 3, '张明');

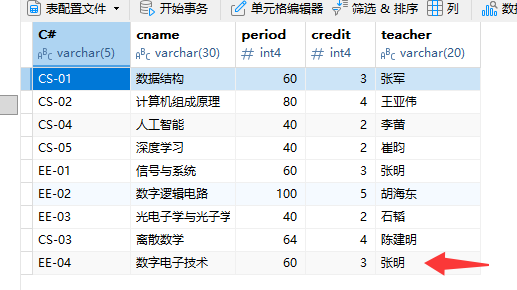
UPDATE C046 SET PERIOD = 36, CREDIT = CREDIT + 1 WHERE CNAME = '数字电子技术' AND TEACHER = '张明';

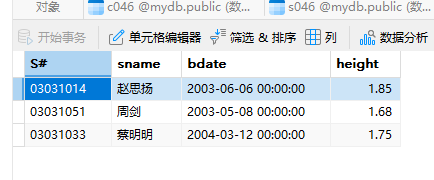
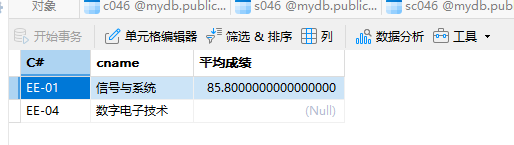
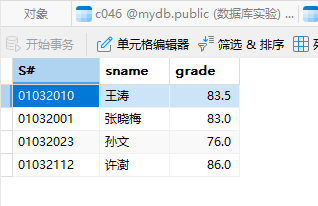
3.5 建立视图
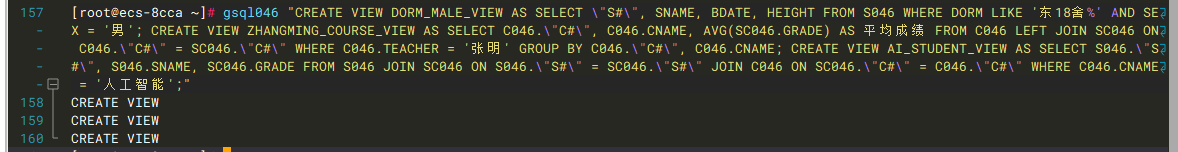
建立下列视图
- 居住在“东18舍”的男生视图,包括学号、姓名、出生日期、身高等属性。
- “张明”老师所开设课程情况的视图,包括课程编号、课程名称、平均成绩等属性。
- 所有选修了“人工智能”课程的学生视图,包括学号、姓名、成绩等属性。
CREATE VIEW DORM_MALE_VIEW AS
SELECT "S#", SNAME, BDATE, HEIGHT
FROM S046
WHERE DORM LIKE '东18舍%' AND SEX = '男';

CREATE VIEW ZHANGMING_COURSE_VIEW AS
SELECT C046."C#", C046.CNAME, AVG(SC046.GRADE) AS 平均成绩
FROM C046
LEFT JOIN SC046 ON C046."C#" = SC046."C#"
WHERE C046.TEACHER = '张明'
GROUP BY C046."C#", C046.CNAME;

CREATE VIEW AI_STUDENT_VIEW AS
SELECT S046."S#", S046.SNAME, SC046.GRADE
FROM S046
JOIN SC046 ON S046."S#" = SC046."S#"
JOIN C046 ON SC046."C#" = C046."C#"
WHERE C046.CNAME = '人工智能';
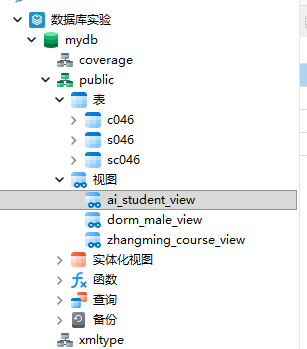
在Navicat中查看
4 数据扩充
4.1 数据扩充至约1000/100/20000行
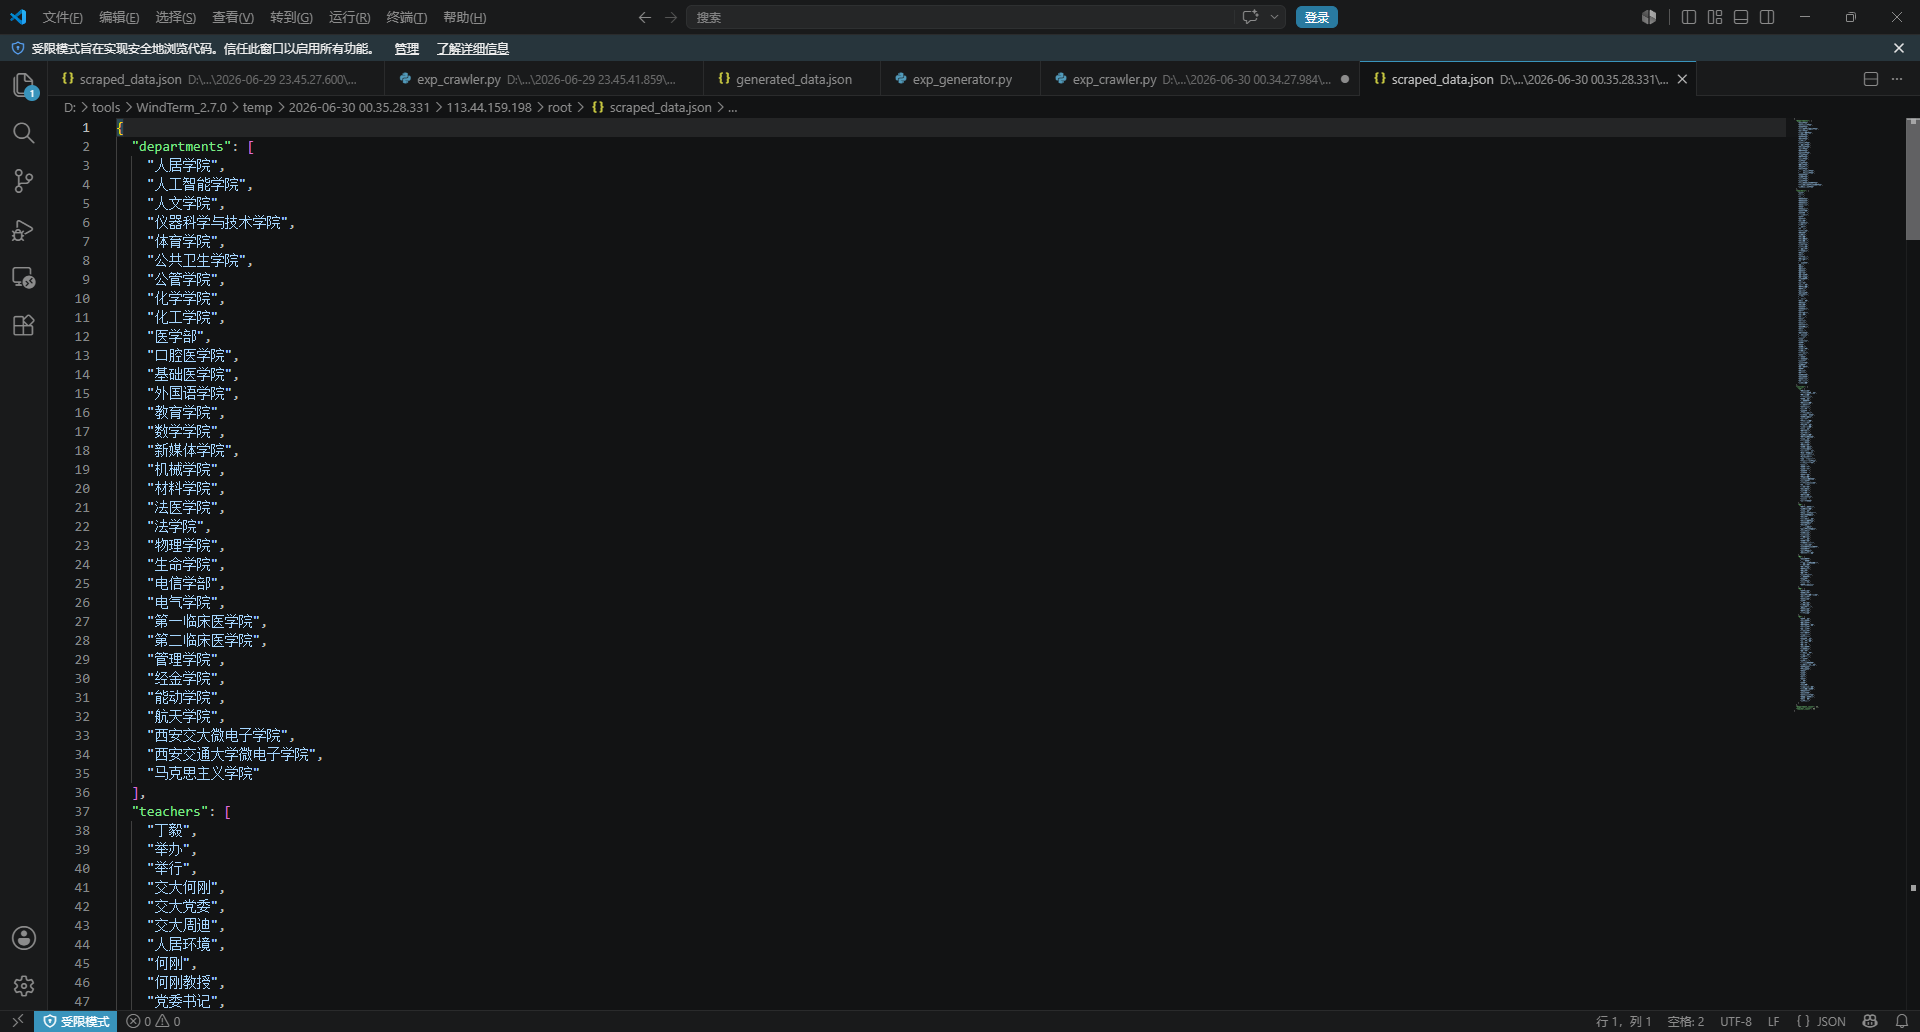
通过 Python requests 库爬取西安交通大学官网https://www.xjtu.edu.cn/及https://news.xjtu.edu.cn/,脚本程序附于附录中
部分结果如下
部分核心代码(exp_crawler.py):
import requests, re
def crawl_departments():
    resp = requests.get('https://www.xjtu.edu.cn/', headers=HEADERS, timeout=15)
    pattern = r'([\u4e00-\u9fa5]{2,10}(?:学院|学部))'
    departments = list(set(re.findall(pattern, resp.text)))
    return sorted(departments)
def crawl_teacher_names():
    teachers = set()
    for url in ['https://news.xjtu.edu.cn/', ...]:
        resp = requests.get(url, headers=HEADERS, timeout=10)
        names = re.findall(r'([\u4e00-\u9fa5]{2,4})(?:教授|院士|研究员)', resp.text)
        teachers.update(names)
    return sorted(teachers)
然后使用Python脚本对爬取到的数据进行清洗,另外对没爬到的数据采用程序进行生成
学生数据生成策略:
- 学号:8位数字,前缀从
01032~07033中随机选取,后3位随机 - 姓名:姓氏库(100个常见姓)+ 名字库(男女各80+字),男女比例约1:1
- 出生日期:2003~2006年随机
- 身高:男
N(1.75, 0.07),女N(1.62, 0.05)正态分布 - 宿舍:按性别分配不同宿舍楼 + 随机房间号
课程数据生成策略: - 课程编号:
CS-xx、EE-xx、MA-xx、PH-xx、OT-xx五大类 - 课程名称:从爬取的课程库中选取
- 学时:32/36/40/48/60/64/72/80/96/100/120/128 随机
- 学分:根据学时计算(学时÷15~24)
- 教师:从爬取的教师名单中随机分配
选课数据生成策略: - 学生与课程随机配对,去重
- 成绩分布:80% 及格(60~100,正态分布 N(78,10)),15% 不及格(0~59),5% NULL
得到结果如下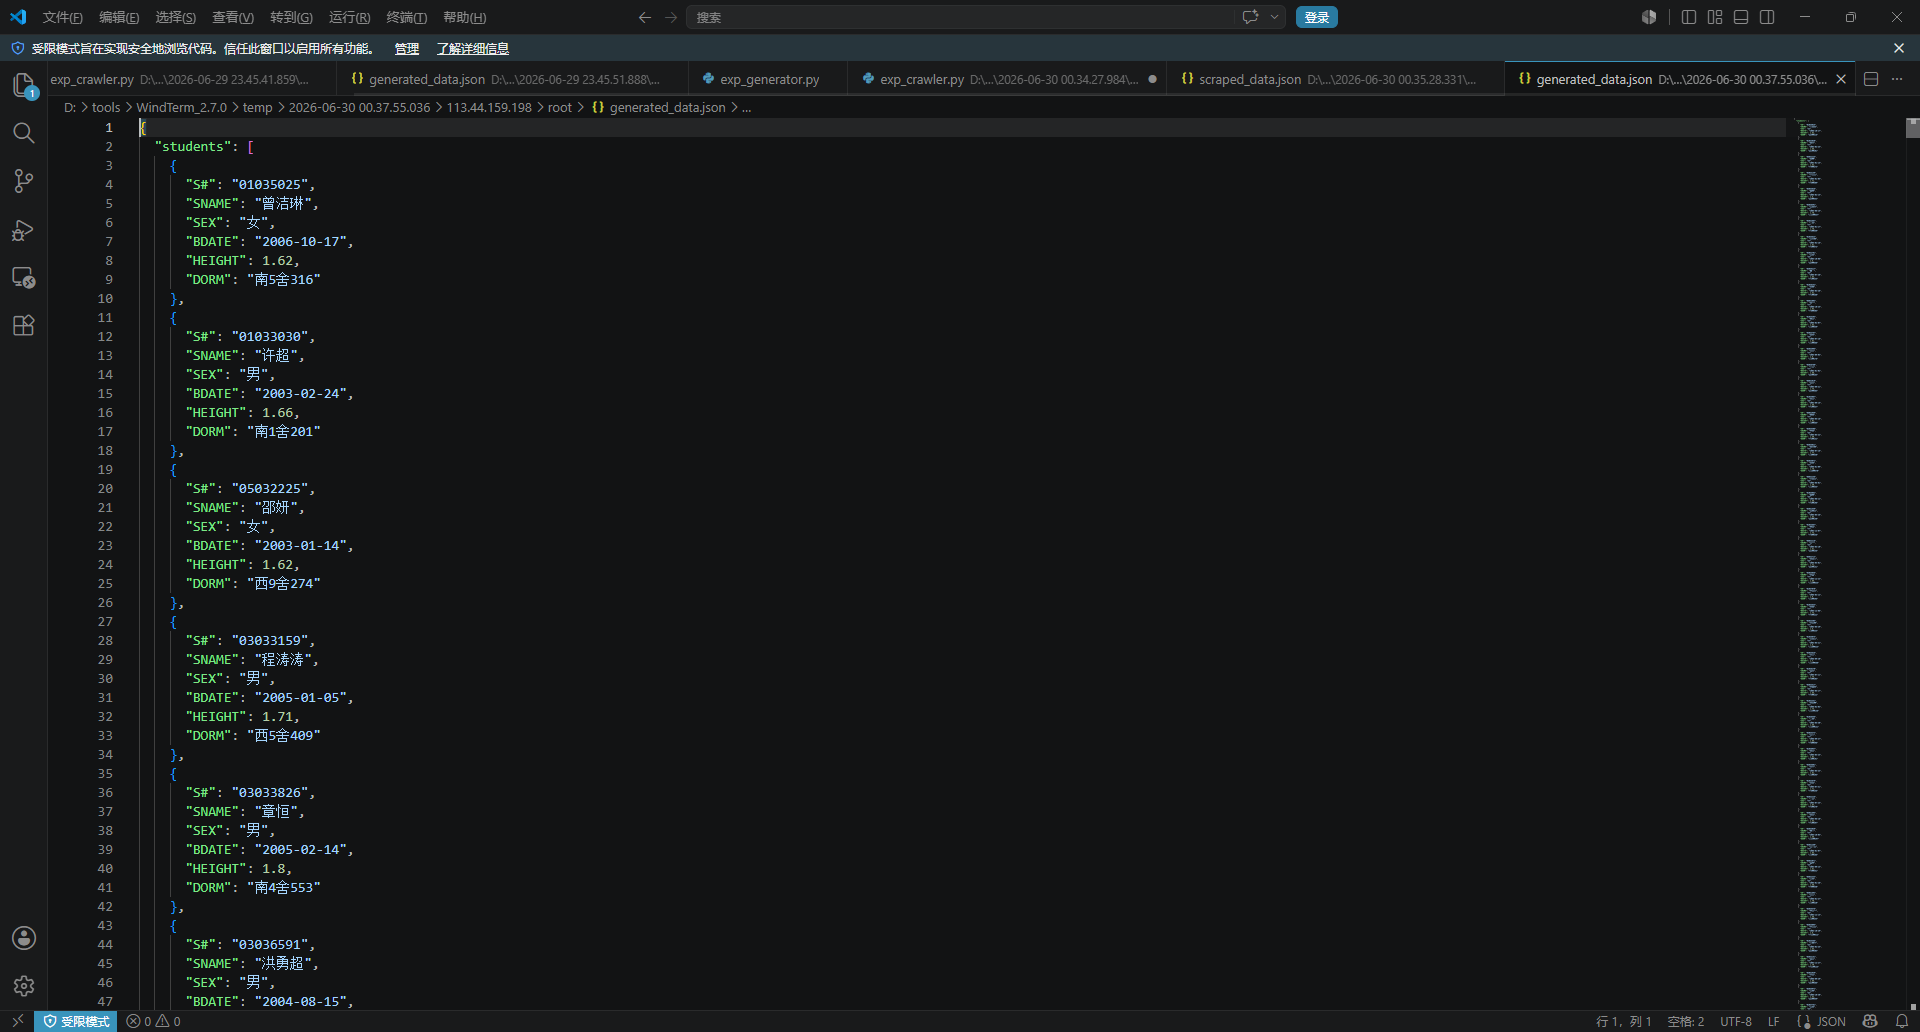
使用 Java + openGauss JDBC 驱动,10 线程并发批量插入:
Java 程序(JdbcWriter.java)核心逻辑:
static final String URL = "jdbc:postgresql://127.0.0.1:15432/mydb";
static final String USER = "navicat";
static final int BATCH_SIZE = 500;
static final int THREAD_COUNT = 10;

static void insertFile(String filePath) throws Exception {
    List<String> lines = readAllLines(filePath);
    ExecutorService pool = Executors.newFixedThreadPool(THREAD_COUNT);
    for (int t = 0; t < THREAD_COUNT; t++) {
        final int threadId = t;
        pool.submit(() -> {
            Connection conn = DriverManager.getConnection(URL, USER, PASS);
            conn.setAutoCommit(false);
            Statement stmt = conn.createStatement();
            for (int i = threadId; i < total; i += THREAD_COUNT) {
                stmt.addBatch(lines.get(i));
                if (count % BATCH_SIZE == 0) {
                    stmt.executeBatch();
                    conn.commit();
                }
            }
        });
    }
    pool.shutdown();
}
并根据要求随机选择成绩低于60分(含NULL)的200行选课记录删除
DELETE FROM SC046 WHERE ("S#", "C#") IN (
    SELECT "S#", "C#" FROM SC046
    WHERE GRADE < 60 OR GRADE IS NULL
    ORDER BY RANDOM() LIMIT 200
);
删除后SC046剩余19800行
结果如下
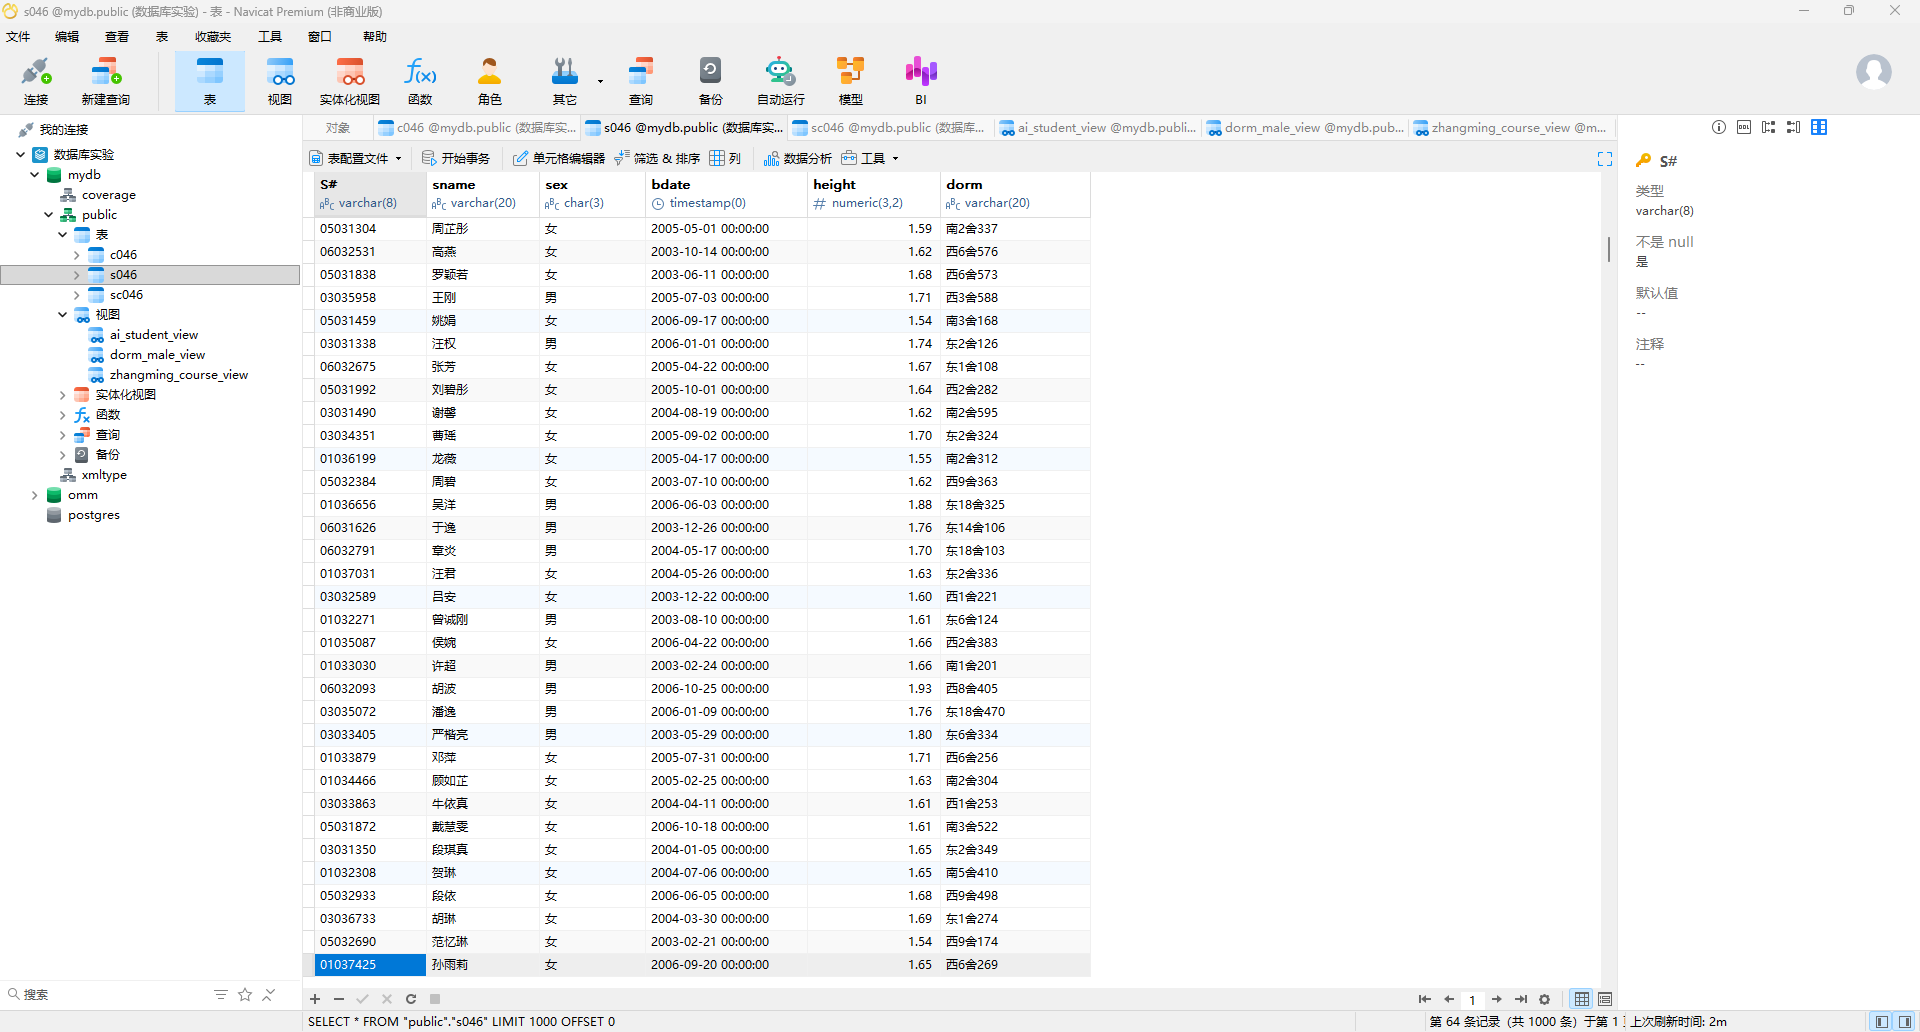
Navicat中一页只展示1000行,其余需翻页查看
4.2 据扩充至约5000/1000/200000行
此时发现C#长度不够,同时对其他主键进行拓宽,另外此时爬取的数据不够,这里通过使用DeepSeekV4Pro在已爬取到的数据上再进行扩展生成,方法与上一步类似这里不再过多赘述
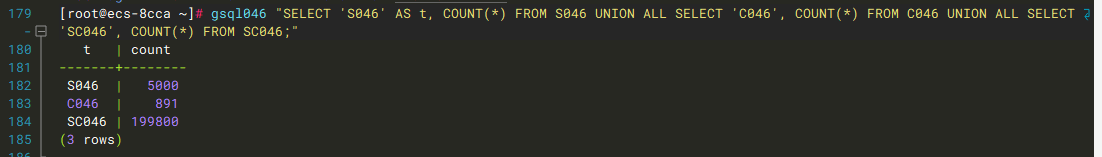
4.2.1 查询计算机系(CS)所开课程的课程编号、课程名称及学分数
写法A(LIKE 模糊匹配):
SELECT "C#", CNAME, CREDIT FROM C046 WHERE "C#" LIKE 'CS-%';
写法B(LEFT 函数截取):
SELECT "C#", CNAME, CREDIT FROM C046 WHERE LEFT("C#", 2) = 'CS';
写法C(范围查询,利用索引):
SELECT "C#", CNAME, CREDIT FROM C046
WHERE "C#" >= 'CS-' AND "C#" < 'CS.' ORDER BY "C#";
效率分析:
- 写法A使用 LIKE 通配符,无法利用 B-tree 索引,需全表扫描
- 写法B使用函数 LEFT(),同样无法利用索引
- 写法C使用范围查询,可以利用 "C#" 主键索引,效率最高
采用脚本测试效率,每个查询执行3次取平均
| 写法 | 执行计划 | 平均耗时 |
|---|---|---|
| A. LIKE 'CS-%' | Seq Scan(全表扫描) | 0.7 ms |
| B. LEFT("C#", 2) = 'CS' | Seq Scan(函数无法用索引) | 1.1 ms |
| C. 范围查询 >= 'CS-' AND < 'CS.' | Index Scan(主键索引) | 0.5 ms |
4.2.2 查询未选修课程"CS-05"的男生学号及其已选各课程编号、成绩
写法A(NOT IN 子查询):
SELECT S046."S#", SC046."C#", SC046.GRADE
FROM S046 JOIN SC046 ON S046."S#" = SC046."S#"
WHERE S046.SEX = '男'
  AND S046."S#" NOT IN (
    SELECT "S#" FROM SC046 WHERE "C#" = 'CS-05'
  );
写法B(NOT EXISTS 关联子查询):
SELECT S046."S#", SC046."C#", SC046.GRADE
FROM S046 JOIN SC046 ON S046."S#" = SC046."S#"
WHERE S046.SEX = '男'
  AND NOT EXISTS (
    SELECT 1 FROM SC046 X
    WHERE X."S#" = S046."S#" AND X."C#" = 'CS-05'
  );
写法C(LEFT JOIN + IS NULL):
SELECT S046."S#", SC046."C#", SC046.GRADE
FROM S046
JOIN SC046 ON S046."S#" = SC046."S#"
LEFT JOIN SC046 X ON X."S#" = S046."S#" AND X."C#" = 'CS-05'
WHERE S046.SEX = '男' AND X."S#" IS NULL;
效率分析:
- 写法A的
NOT IN在子查询结果较大时效率较低,且遇到 NULL 值会有语义问题 - 写法B的
NOT EXISTS一旦找到匹配即停止扫描,效率优于 NOT IN - 写法C的
LEFT JOIN + IS NULL是经典的反连接(Anti-Join),数据库可优化为 Hash Anti-Join,在大数据量下效率最高
| 写法 | 执行计划 | 平均耗时 |
|---|---|---|
| A. NOT IN 子查询 | Hash Join + Nested Loop Anti Join | 289.0 ms |
| B. NOT EXISTS | Hash Join + Nested Loop Anti Join | 275.2 ms |
| C. LEFT JOIN + IS NULL | Hash Join + Nested Loop Anti Join | 279.1 ms |
4.2.3 查询每位学生的学号、姓名及其已选修课程的学分总数
写法A(三表 JOIN + GROUP BY):
SELECT S046."S#", S046.SNAME, COALESCE(SUM(C046.CREDIT), 0) AS 总学分
FROM S046
LEFT JOIN SC046 ON S046."S#" = SC046."S#"
LEFT JOIN C046 ON SC046."C#" = C046."C#"
GROUP BY S046."S#", S046.SNAME;
写法B(子查询 + 标量计算):
SELECT S046."S#", S046.SNAME,
  (SELECT COALESCE(SUM(C046.CREDIT), 0)
   FROM SC046 JOIN C046 ON SC046."C#" = C046."C#"
   WHERE SC046."S#" = S046."S#") AS 总学分
FROM S046;
写法C(先聚合后连接):
SELECT S046."S#", S046.SNAME, COALESCE(T.总学分, 0) AS 总学分
FROM S046
LEFT JOIN (
  SELECT SC046."S#", SUM(C046.CREDIT) AS 总学分
  FROM SC046 JOIN C046 ON SC046."C#" = C046."C#"
  GROUP BY SC046."S#"
) T ON S046."S#" = T."S#";
效率分析:
- 写法A先做三表全连接再分组,中间结果集巨大(20万行级别),GROUP BY 开销大
- 写法B对每个学生执行一次子查询,5000 次子查询,效率最低
- 写法C先在子查询中完成 SC046 与 C046 的聚合(结果仅约5000行),再与学生表 LEFT JOIN,中间结果集小,效率最高
| 写法 | 执行计划 | 平均耗时 |
|---|---|---|
| A. 三表JOIN + GROUP BY | HashAggregate(20万行聚合) | 305.5 ms |
| B. 标量子查询 | 5000次子查询(loops=5000) | 1746.0 ms |
| C. 先聚合后连接 | HashAggregate(子查询先聚合) | 196.1 ms |
4.3.1 优化
- 创建索引:
CREATE INDEX idx_sc_sno ON SC046("S#");
CREATE INDEX idx_sc_cno ON SC046("C#");
CREATE INDEX idx_s_sex ON S046(SEX);
CREATE INDEX idx_c_teacher ON C046(TEACHER);
- 使用HINT指令引导执行计划:
-- 强制使用HashJoin
SELECT /*+ HashJoin(S046 SC046) */ S046."S#", SC046."C#", SC046.GRADE
FROM S046 JOIN SC046 ON S046."S#" = SC046."S#"
WHERE S046.SEX = '男';

-- 强制使用索引扫描
SELECT /*+ IndexScan(C046 c046_pkey) */ "C#", CNAME, CREDIT
FROM C046 WHERE "C#" >= 'CS-' AND "C#" < 'CS.';
- 改变存取路径:
- 将
NOT IN改为NOT EXISTS或LEFT JOIN ... IS NULL(反连接) - 将三表 JOIN 改为先聚合后连接,减少中间结果集
- 将
LIKE模糊匹配改为范围查询,利用 B-tree 索引
5 数据备份及恢复
与计算机2305张玲瑜同学合作完成
恢复其数据库,其学号后三位为042
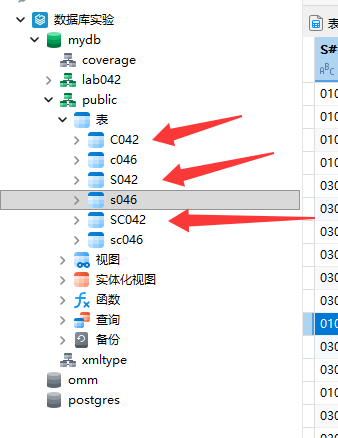
对比表结构
| 属性 | 我的 S046 | 同学 S042 |
|---|---|---|
| S# | VARCHAR(8) | CHAR(8) |
| SNAME | VARCHAR(20) | VARCHAR(20) |
| SEX | CHAR(3) | VARCHAR(4) |
| BDATE | DATE | TIMESTAMP(0) |
| HEIGHT | NUMERIC(3,2) | NUMERIC(3,2) |
| DORM | VARCHAR(20) | VARCHAR(30) |
| 属性 | 我的 C046 | 同学 C042 |
|---|---|---|
| C# | VARCHAR(8) | VARCHAR(10) |
| CNAME | VARCHAR(60) | VARCHAR(40) |
| PERIOD | INTEGER | INTEGER |
| CREDIT | INTEGER | NUMERIC(3,1) |
| TEACHER | VARCHAR(20) | VARCHAR(20) |
| 这里该同学S#也就是学号采用定长更合理,其余数据类型虽有差别但也均可 | ||
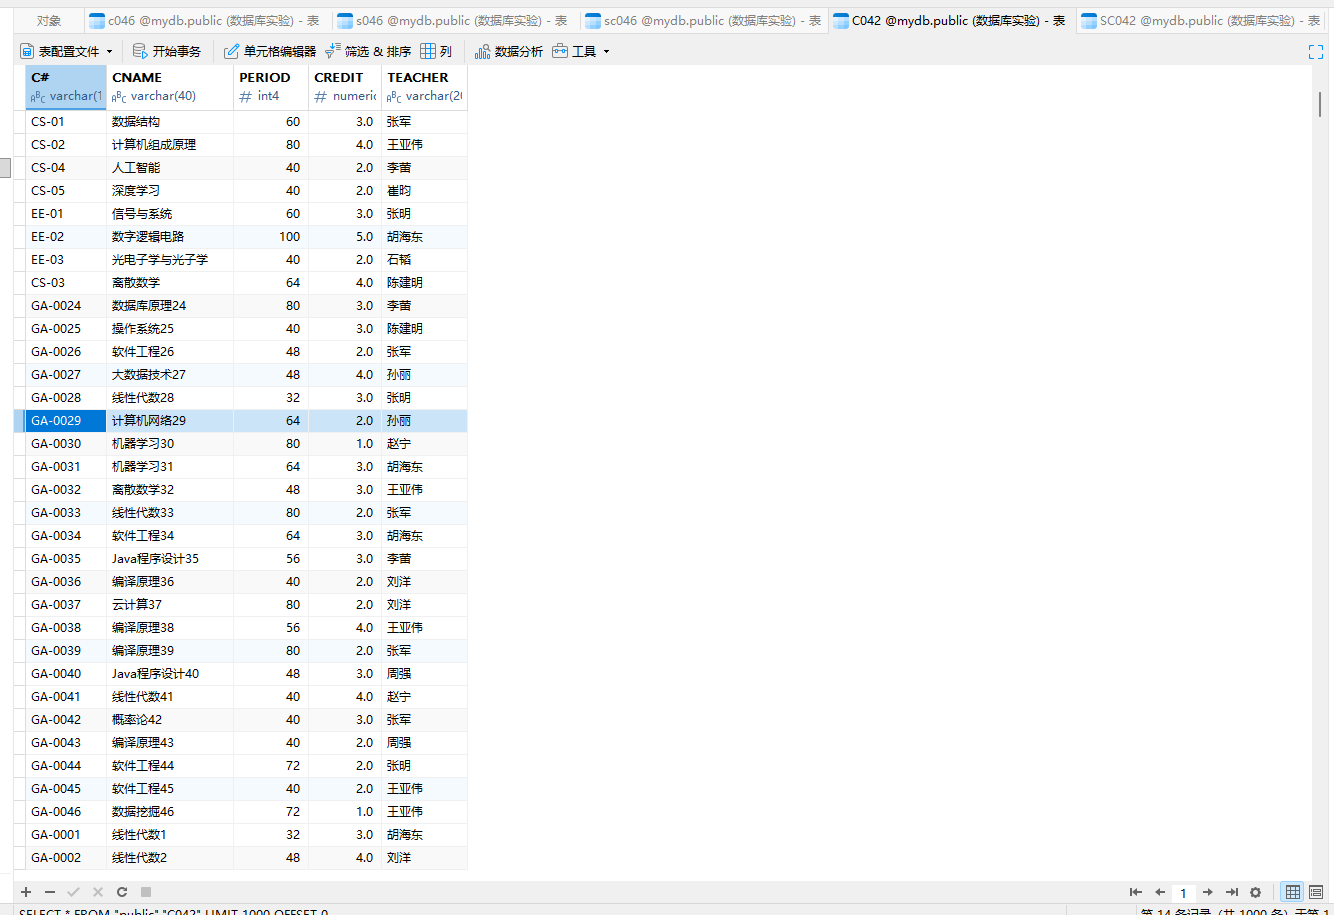
| 不过对于其生成的课程数据 | ||
 |
||
| 发现其GA占比过大,统计如下 |
| 院系 | 课程数 | 分析 |
|---|---|---|
| GA | 992 | 占绝大多数,分类不够多样 |
| CS | 5 | 过少 |
| EE | 3 | 过少 |
该同学的课程分类以 GA 为主,CS 和 EE 仅个位数,分类不够均衡。相比之下,我建立的表C046覆盖 15 个分类(CS/EE/MA/PH/CH/BI/ME/CE/MG/MD/LA/HS/AR/PE/FL),分布更均匀。
对于其余数据,学生数据和选课数据均合理,没有问题
| 指标 | 值 | 评价 |
|---|---|---|
| 男/女 | 2436 / 2564 | 比例约 1:1,合理 |
| 身高范围 | 1.50 ~ 1.90 | 合理范围 |
| 身高均值 | 1.7005 | 合理 |
| 出生年份 | 2002 ~ 2007 | 合理 |
| 指标 | 值 | 评价 |
|---|---|---|
| 及格(≥60) | 170,058 (85.0%) | 合理 |
| 不及格(<60) | 23,892 (12.0%) | 合理 |
| NULL | 6,050 (3.0%) | 合理 |
| 选课学生数 | 4,999 | 几乎全部学生都有选课 |
| 被选课程数 | 997 | 几乎全部课程都被选中 |
6 设计触发器
6.1 创建备份表 BK046
CREATE TABLE BK046 (
    "S#"     VARCHAR(8),
    "C#"     VARCHAR(8),
    GRADE    NUMERIC(4,1),
    DDATE    TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
| 列 | 类型 | 说明 |
|---|---|---|
| S# | VARCHAR(8) | 学号 |
| C# | VARCHAR(8) | 课程号 |
| GRADE | NUMERIC(4,1) | 成绩 |
| DDATE | TIMESTAMP | 删除时间,精确到微秒 |
 |
6.2 创建触发器函数
CREATE OR REPLACE FUNCTION backup_sc046_delete()
RETURNS TRIGGER AS $$
BEGIN
    INSERT INTO BK046 ("S#", "C#", GRADE, DDATE)
    VALUES (OLD."S#", OLD."C#", OLD.GRADE, pg_systimestamp());
    RETURN OLD;
END;
$$ LANGUAGE plpgsql;
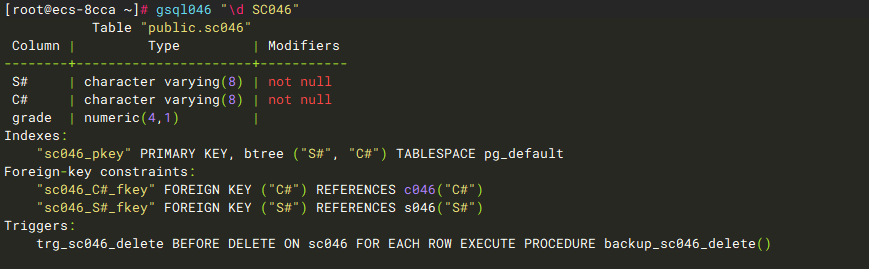
6.3 创建触发器
CREATE TRIGGER trg_sc046_delete
BEFORE DELETE ON SC046
FOR EACH ROW
EXECUTE PROCEDURE backup_sc046_delete();
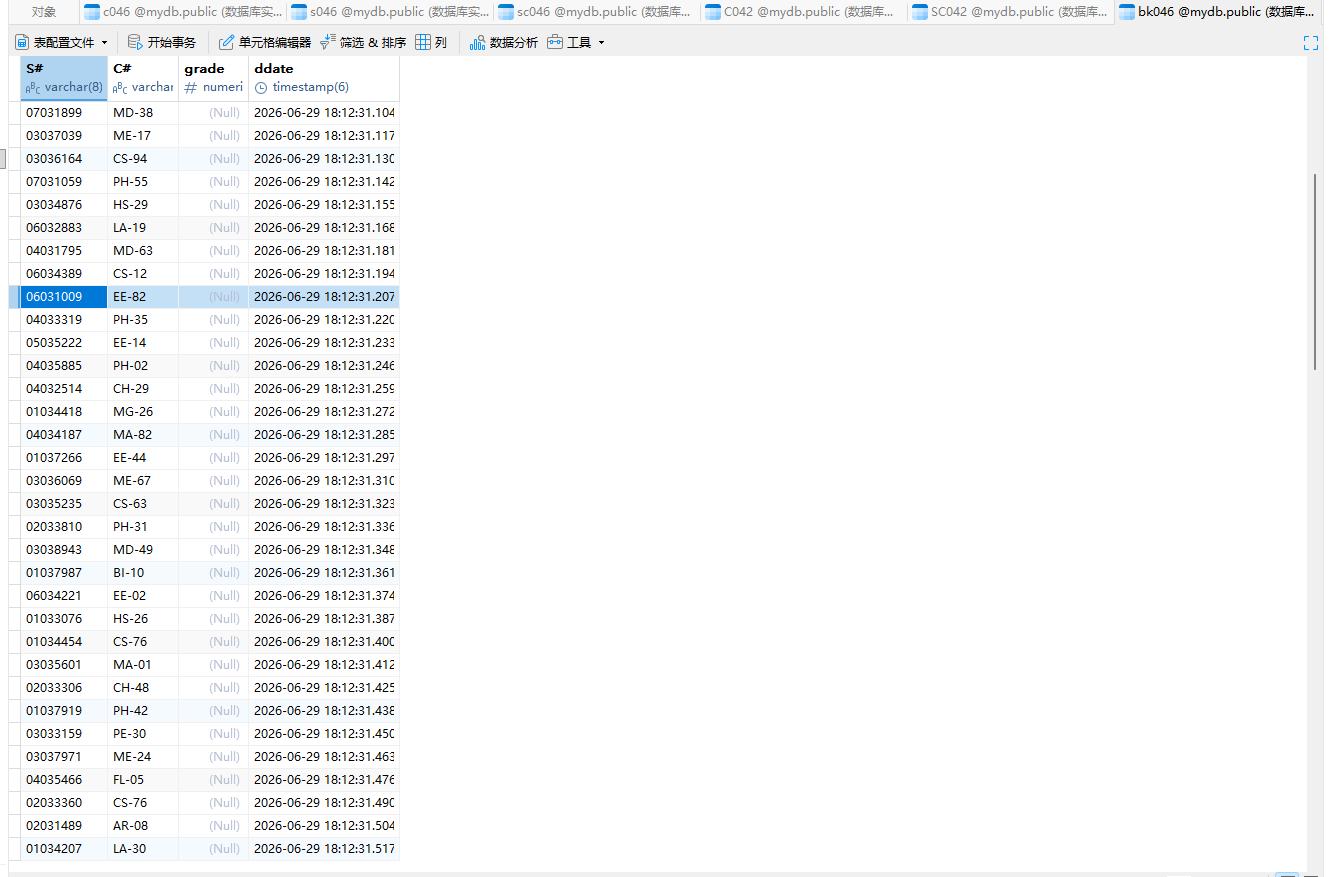
6.4 Python脚本逐条删除 NULL 成绩记录
import psycopg2, time

CONN = "host=127.0.0.1 port=15432 dbname=mydb user=navicat password=QwErTy@123!"
DELETE_COUNT = 100

conn = psycopg2.connect(CONN)
cur = conn.cursor()

# 随机选取100条GRADE为NULL的记录
cur.execute('SELECT "S#", "C#" FROM SC046 WHERE GRADE IS NULL ORDER BY RANDOM() LIMIT 100')
records = cur.fetchall()

# 逐条删除,触发器自动备份到BK046
for sno, cno in records:
    cur.execute('DELETE FROM SC046 WHERE "S#" = %s AND "C#" = %s', (sno, cno))
    conn.commit()
    time.sleep(0.01)  # 确保时间戳有差异

cur.close()
conn.close()
6.5 执行结果
实验总结
本次实验基于华为云 openGauss 数据库,完成了从建表、数据录入、复杂查询、视图创建到大规模数据生成、查询优化、备份恢复及触发器设计的全流程实践。通过本次实验,熟练掌握了 DDL/DML/DQL 的编写,能够综合运用连接查询、嵌套查询、聚合函数完成复杂检索。在数据扩充环节,采用 Python 爬取真实数据结合程序生成的方式构造了合理的大规模数据集,并通过 Java JDBC 多线程批量写入,显著提升了数据入库效率。查询优化部分通过对比不同 SQL 写法及利用索引、Hint 指令进行分析,加深了对执行计划与存取路径的理解。备份恢复与合作同学的交叉验证进一步锻炼了数据库运维与设计评估能力。触发器的实现则完整演示了数据变更审计的典型应用场景。本次实验覆盖了数据库课程的核心知识点,有效提升了工程实践能力。